端侧AI与低延迟
模型在本地完成推理,减少往返云端的等待,让响应更贴近即时交互的节奏。
模型在本地完成推理,减少往返云端的等待,让响应更贴近即时交互的节奏。
语音、视觉与文本在同一套终端框架内协同,设备能同时理解多种输入信号。
Agent可根据场景与习惯主动发起提醒与建议,而不必等待用户逐条下达指令。
基于统一互联标准打通不同品牌的灯具、传感器与家电,减少生态割裂带来的重复配置。
敏感数据优先在设备侧处理,配合分级授权与加密传输,降低信息外泄的风险面。
提供标准化接入接口与开发文档,方便硬件厂商与开发者把设备纳入同一管理视图。
Bwin 必赢是一个聚焦AI芯片与智能设备的资讯与选型参考站点,围绕端侧AI、AI Agent、多模态交互与AIoT等方向持续整理公开信息。我们希望把分散在论文、发布会与开发者文档中的技术要点,转写成普通读者也能读懂的说明。
站点内容以芯片架构、算力与功耗权衡、互联协议适配、隐私计算实践为主线,覆盖智能家居、可穿戴设备、AI眼镜、AI耳机、AI PC与AI手机等终端形态。每篇内容都尽量标注信息来源与适用边界,避免把实验室结论直接当成量产现实。
我们不对具体产品的性能做保证性判断,也不发布未经核实的排名。所有编辑内容以可复核、可追溯为基本原则,读者可据此自行判断某项技术是否适合自己的使用场景。
关注设备端数据处理的合规框架,整理常见隐私认证的适用条件与覆盖范围,帮助读者理解认证结论能说明什么、不能说明什么。
以公开技术文档、标准组织资料与厂商发布信息为主要来源,交叉比对后成文,尽量还原技术演进的实际脉络。
内容更新与反馈通道保持全天可用,读者提交的纠错与补充建议会在核对后进入修订流程,保证长期可查。
最初以整理芯片发布会与开发者文档为主,形成早期的技术条目库。
内容范围延伸到智能家居与可穿戴,开始按设备类别建立对比维度。
围绕NPU算力、内存带宽与功耗预算,输出面向选型的分析框架。
把Matter/Thread等互联标准纳入选题,讨论跨品牌协同的实际障碍。
持续跟踪Agent调度与多模态输入的工程实践,补充隐私计算相关内容。
整理量化、剪枝与算子适配的常见做法,说明不同精度方案对延迟与内存的实际影响。
按算力、功耗、接口与软件栈成熟度列出对照维度,帮助读者缩小候选范围。
围绕Matter/Thread与主流无线协议,说明配网、组网与跨品牌控制的实现路径。
讨论语音、视觉与触控在同一设备中的优先级与冲突处理,减少交互歧义。
介绍本地处理、脱敏上报与分级授权的组合方式,明确各类数据的留存边界。
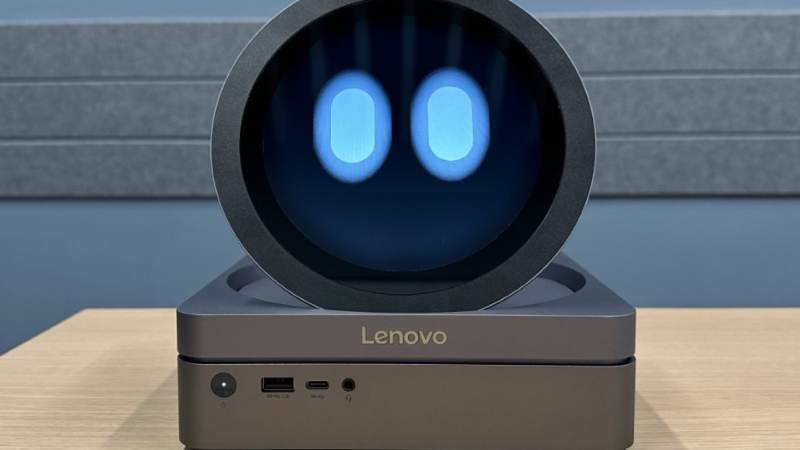 端侧AI
低比特量化能压缩显存占用,但不同任务对精度损失的耐受度差异明显,需要分场景评估。
当多个Agent同时运行时,任务优先级与唤醒频率直接决定续航表现。
频段干扰、证书状态与边界路由器配置是配网失败中出现频率较高的三类原因。
显示、传感与推理三部分争夺同一块电池,取舍方式决定了产品的实际可用时长。
把全部计算放在端侧并不总是最优,带宽成本与响应要求共同决定分工方式。
哪些数据必须留在设备内、哪些可以脱敏上报,需要在产品设计早期就明确。
通常先在设备端进入配网模式,再通过对应应用完成发现与绑定。添加后可在设备列表里修改名称、分配房间并设置自动化触发条件。
在设备详情页的通知设置中可以分别开启或关闭固件更新提醒。关闭后设备仍可手动检查更新,只是不再主动推送提示。
支持。常用场景可加入收藏列表置顶显示,自动化规则可以复制后修改条件,便于在相似房间之间快速复用。
语音与图像等敏感数据优先在本地处理,需要上传时进行脱敏。用户可在隐私设置中查看数据用途说明并随时撤回授权。
具体支持范围取决于设备的芯片算力与系统版本,通常在设备规格页会列出可用的语音服务与大模型接入方式。
端侧推理那几篇写得很实在,把延迟和功耗的取舍讲清楚了,选型时省了不少来回查资料的时间。
Matter配网失败原因那篇帮我定位到了频段干扰问题,照着排查一遍就通了,很实用。
内容更新比较稳,不会堆一堆夸张标题,术语也都有解释,读起来不费劲。
关于隐私计算那一节讲得比较克制,没有过度承诺,反而让人更愿意相信里面的结论。
可穿戴设备的功耗分析很到位,我把里面提到的显示与传感预算思路用在了自己的方案里。
页面打开速度快,手机上读长文也不卡,旧文章还能翻到,这点比很多同类站点做得好。
从乘加阵列到稀疏计算,架构调整的目标始终是在有限功耗下换取更稳定的推理吞吐。
把计算单元靠近存储可以缓解数据搬运瓶颈,但工艺与良率仍是量产阶段的主要变量。
开放指令集便于定制扩展,适合作为协处理器控制核,与专用加速单元形成分工。
模型权重占用与上下文长度共同推高内存需求,容量与带宽往往比峰值算力更关键。
实时降噪需要持续占用算力,如何在保证续航的前提下维持效果是设计的核心矛盾。
同一空间内多种无线协议并行时,信道占用与干扰协调直接影响到设备响应的一致性。